
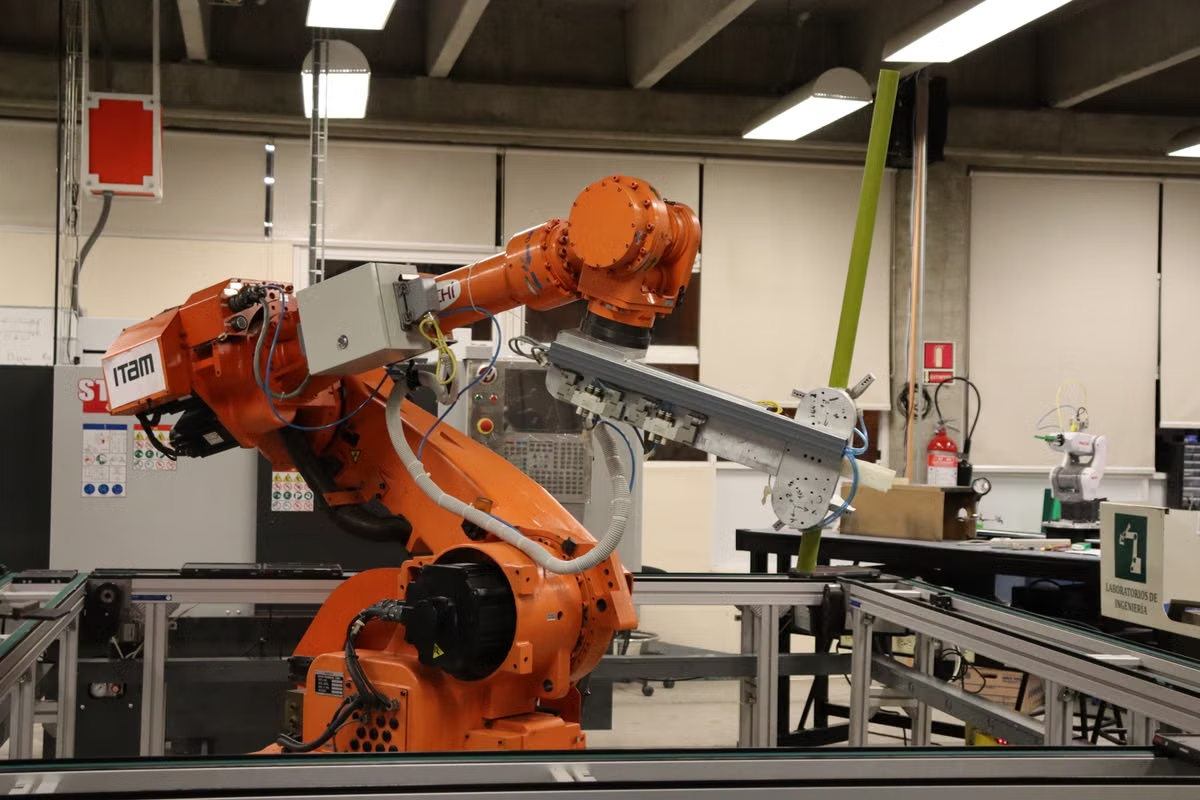
AI 从电脑走向机器人,意味着 Agent 可以规划任务、视觉模型可以理解环境,再由机器人执行物理动作。Google DeepMind 对 RT-2 的研究评估进行了 超过 6,000 次机器人试验,测试模型能否把视觉和语言信息转成动作;这是受控研究结果,不代表机器人已能普遍自主工作。RT-2 技术介绍与试验说明
症状:你看到机器人理解指令、拿起物品的演示,却不确定它能否在真实工作环境里稳定完成任务。
最快解法:先确认任务是否可拆解、环境是否可控、失败是否安全;满足这些条件,再让 Agent 规划、视觉模型识别、机器人执行,并保留人工接管。
这篇文章适合关注具身智能、想辨别演示与实际部署差异的读者。
如果你正在开发 Agent,或评估机器人项目,也可以用下面的流程判断任务是否适合自动化。
AI 从电脑走向机器人:从生成答案到执行动作
在电脑上,Agent 的输出通常是文字、代码或工具调用;走向机器人后,输出会影响机械臂、夹爪或移动底盘。基本协作链是:Agent 理解目标并安排步骤,视觉模型分析相机画面,机器人控制模块把计划转成物理动作,再通过传感器反馈确认结果。
实际系统并非总是由三个彼此独立的模型组成。有些视觉—语言—动作模型会直接把图像和指令映射为动作;另一些系统则把高层规划与低层控制分开。Google DeepMind 对 Gemini Robotics 1.5 的介绍就区分了负责规划与工具调用的具身推理模型,以及输出机器人动作的模型;公开资料说明的是模型能力与演示,不等于任何设备都能直接部署。Gemini Robotics 1.5 的模型分工与可用范围
这项变化最重要的不是“机器人会聊天”,而是系统开始把语义目标接到实体动作上。能否落地,取决于相机、坐标、运动控制、夹具和安全机制是否配合,而不是只看模型能否说出合理步骤。
家庭与服务任务:演示可行,不等于家务通用
在桌面或固定工作台上,机器人可以识别杯子、盒子等目标,根据指令定位物体,再尝试抓取、移动或分类。RT-2 的演示展示了模型如何根据场景和描述选择物体、执行简单操作;这说明视觉语义能帮助机器人处理训练数据之外的部分指令,但仍然是研究系统在特定测试中的表现。
家庭环境更难,因为地面、光线、物品摆放和人的动作随时会变。柔软衣物、透明物品、杂乱桌面或被遮挡的目标,都可能令识别、抓取和放置失败。即使单次演示成功,也不能说明机器人能持续完成整套家务,更不能据此忽略人宠接近、易碎物品和狭窄空间带来的风险。
因此,评估家用或服务机器人时,要把“看懂目标”“抓取成功”“完成多步任务”视为不同能力。公开演示通常能证明某个场景中的可行性;要判断常态部署,还需要了解适用环境、异常处理方式和人类接管条件。
实验室与物流:任务边界清楚时更容易验证
实验室工作台通常有固定设备、明确步骤和可追踪的样本,比开放家庭更容易建立检查点。OpenAI 公布的实验室机器人案例中,系统由语言模型把自然语言流程转成操作、视觉系统识别并定位实验器皿,再由路径规划模块安排动作;机器人完成了液体转移、混合和移动样本等流程。不过,同一说明也报告,机器人实验的绝对菌落数量约比人工操作低一个数量级,并指出液体处理精度和温度校准仍有改进空间。这是具体研究案例,不是所有实验室任务都已自动化的证据。OpenAI 对机器人实验流程及结果的说明
物流和制造场景已有大量用于搬运、分拣、检查的机器人,但需要区分传统自动化与 Agent 驱动的开放式操作。国际机器人联合会的统计显示,2024 年全球工业机器人安装量为 542,000 台;这反映工业机器人部署规模,并不证明这些设备普遍具备通用视觉理解或自然语言规划能力。国际机器人联合会《World Robotics 2025》工业机器人摘要
在结构化场景里,视觉模型可以确认目标物或货位,Agent 可协调“识别—搬运—放置—核验”等环节,机器人执行重复动作。要把这种组合用于生产,还需针对现场物体、光照、路线、设备接口和故障恢复做验证;不能把传统机器人装机数据当成新型具身智能系统的部署证明。
从用户指令到实体动作:五步验证闭环
一个较稳妥的流程,不是让 Agent 一次性生成一串动作后直接执行,而是给每个环节规定输入、核验条件和失败出口:
- 限定目标。把“整理工作台”改成清晰的任务,例如“把识别出的空纸盒放入指定回收箱”。明确哪些物品不许移动。
- 观察并定位。让视觉模型判断对象类别、位置和遮挡情况;若目标不确定,要求系统重新观察或询问人,而不是猜测。
- 生成可检查的子任务。Agent 拆分动作,并为每一步设完成条件,例如到达目标区、夹爪闭合、物体已放入容器。
- 先仿真或低风险试运行。使用仿真、软件在环或硬件在环测试路径和传感器反馈。NVIDIA 对 Isaac Sim 的说明介绍了物理仿真、合成数据以及软件或硬件在环测试用途;仿真能帮助发现问题,但仍不能替代真实硬件上的验证。Isaac Sim 仿真与测试说明
- 执行后复核并留接管口。机器人完成动作后重新观察现场,检查结果是否满足条件;遇到遮挡、碰撞、超出工作区或多次无法确认时,停止自动执行并交由人员处理。
误差会沿链路传递:图像中的物体位置不等于机器人坐标,模型的文字计划也不等于可执行的运动轨迹。相机标定、传感器时序、夹爪状态和路径规划都可能让“看起来合理”的计划在实体环境中失败。
能力边界:哪些任务还不宜完全托管
✅ 较适合验证:目标和动作范围有限、环境布置稳定、结果容易由传感器核验的识别、搬运、分拣或重复检查任务。
⚠️ 需要试点和人工接管:多步骤长流程、物品摆放经常变化、操作对象柔软或容易滑动、任务中可能出现未见情况的场景。
❌ 不应仅凭演示放手:动作失败可能伤人、造成重大损失,或需要处理危险物品且缺少可靠安全联锁的任务。
具身智能研究也没有绕过传统工程的安全责任。国际标准化组织的 ISO 10218-1:2025 规定工业机器人自身的安全要求;机器人集成和应用还涉及相应的系统层要求。它不能替代项目的风险评估,也不意味着通用家用机器人已经获得安全保证。ISO 10218-1:2025 标准范围说明
研究论文与演示能说明能力正在推进,但评测环境、机器人机型和任务定义会影响结果。ICML 论文《Hi Robot》研究开放式指令跟随的分层视觉—语言—动作模型;这类工作应按论文所报告的实验条件理解,而不是直接外推成任意场景中的稳定应用。ICML 2025 论文与实验摘要
注意:如果供应商只展示顺利完成的视频,却没有说明失败时如何停机、如何复位、由谁接管,就还缺少判断部署风险的关键信息。
场景决策清单:先评估再扩大自动化
| 评估维度 | 适合先试点 | 应先保留人工操作 |
|---|---|---|
| 环境 | 固定工位、目标区域清晰、变化可记录 | 人员和物品随机进入,遮挡或布局频繁变化 |
| 动作 | 搬运、放置等动作容易检查,失败可撤回 | 动作不可逆,或可能伤人、损坏设备和样品 |
| 结果 | 摄像头或传感器能判断是否完成 | 成功标准模糊,系统无法可靠复核 |
| 异常 | 可安全暂停、退回上一步并通知人员 | 异常后没有可靠停机、复位或人工接管方式 |
开始验证时,先挑一个边界明确、失败后果低的任务,再逐项记录识别错误、动作偏差和人工介入原因。只有当任务定义、现场测试和安全机制都能覆盖真实异常时,才考虑扩大自动运行范围。
FAQ:从 Agent 到机器人动作
这三类技术搭配后,哪些工作适合先自动化?
在任务明确、环境受控时,它们可以配合完成物体识别、定位、取放、分拣、搬运或巡检。Agent 负责拆解目标和协调工具,视觉模型提供环境信息,机器人执行动作并反馈结果。公开演示只能证明特定系统在特定条件下做到了这些事,不能直接证明它在陌生环境里也可靠。
从相机画面到机器人的抓取动作,中间有哪些环节?
视觉模型先从相机画面识别目标和相对位置,系统再结合机器人坐标、深度或其他传感器信息规划动作。机器人执行后,应再次观察并核对结果。光线变化、遮挡、坐标标定误差或物体移动,都可能造成识别正确但抓取失败,因此闭环复核比一次性“看图下令”更重要。
一句自然语言指令如何变成可执行的机器人步骤?
Agent 可以把目标拆成一串有完成条件的子任务,再调用视觉识别、导航或机械臂控制模块。例如先确认物体和容器,再规划移动、抓取、放置,最后核验。工程实现还要设定超时、失败重试和中止条件;不能把自然语言计划直接当作安全的底层电机指令。
哪些异常或高风险动作应触发人工接管?
当目标识别不确定、现场与测试环境差异过大、动作不可逆或失败可能伤人时,应请求人工确认。机器人也应在无法验证上一步是否成功、出现碰撞或超出安全范围时暂停。人工接管不是模型能力不足的临时补丁,而是高风险自动化系统的必要设计环节。
如果你计划从电脑端 Agent 原型继续验证机器人应用,先把任务拆分、模拟测试、实体设备控制和安全接管分别评估。远程 Mac 环境可用于 macOS 相关的 Agent 开发、构建或测试,但它不是机器人实时控制硬件;你可以先了解 Kvmzen 的服务背景,再通过 Kvmzen 帮助中心核对开发环境的适用边界,判断项目是否需要这类环境。